Report2Alpha-Bench:评测大模型智能体完成端到端量化研究的能力
本文用真实券商研报构造了一项端到端的量化研究任务,并在模型没见过的行情上客观打分。
大模型智能体已经能在终端里连续工作数小时,完成软件工程、机器学习实验和论文复现这类任务。任务从“回答一个问题”变成“完成一项研究”之后,一个更难回答的问题随之出现:它真的会做研究吗?
我们用 7 篇券商金融工程研报构造了一套端到端的量化研究评测 Report2Alpha-Bench。模型读一篇研报,在 7 轮迭代中提出假设、编写因子代码、阅读回测反馈,最后自己决定提交什么;提交冻结之后,由独立评分器在模型从没见过的 2024–2025 年行情上回放打分。本文报告 4 个模型的首轮结果。
先说结论。4 个模型在这次运行中分成两档:gpt-6.1-sol 和 gpt-6.1-terra 约 46–50 分,deepseek-v4.1-flash 和 muse-spark-1.3 约 23–24 分(百分制),差距主要由 7 道题中的两道拉开。差距不在读懂研报,也不在找候选——在训练期,四个模型几乎没有区别;差距出现在最后一步:训练期好看的因子,换到新行情还成不成立。
01 / 难的不是生成,而是判断
假设可以批量生成,难的是判断哪些站得住:有没有用到未来信息,推导是否成立,换到样本外还有没有效。
评测本身也面临同样的问题。研究的产出往往没有唯一正确答案,靠人工或 LLM 评审打分,成本高,也难以复现。要评“会不会做研究”,需要这样一类任务:过程开放、需要长程规划,结果却能被客观、自动地打分。
量化选股研究恰好满足这个条件。它的“标准答案”就是未来的行情本身:一个因子好不好,放到模型没见过的行情上跑一遍就知道。
已有的金融评测大多考问答、文档理解或交易决策;最接近的 Investor's Last Exam(ILE)评测基本面研究的完整工作流,但依赖评分细则和 LLM 裁判。通用智能体评测如 Terminal-Bench,则用测试脚本判定任务是否完成。Report2Alpha-Bench 的不同在于:评测对象是一项端到端的量化研究,产出是可执行的因子代码,评分是新行情上的确定性回测,不依赖 LLM 裁判。我们还从运行记录中度量研究过程,用来回答“差在哪一步”。
02 / 任务:读一篇研报,交出一组因子
所谓因子,是每天给每只股票打的一个分数,用来预测它未来的相对收益。因子在每个交易日开盘时计算,只能使用当时已经知道的数据;用到开盘之后才产生的数据(比如当天的收盘价),叫作前视,属于作弊。
模型拿到三样东西:一篇几十页、夹杂公式和图表的券商金工研报;一份只读的历史行情,包括日频、分钟和逐笔派生指标,共 1,454 个字段、5,524 只股票;以及一套可调用的编译和回测工具。它要交出最终选定的因子 C++ 源码和一份选择说明,也可以选择不提交。
一次研究分三步(图 1)。先读懂研报、写出计划;然后在 7 轮里反复“提出想法 → 实现 → 看反馈 → 调整”,其中第 0 轮按研报原式实现基线,第 1–6 轮由模型自己提出新假设;最后从自己产出的上百个候选里决定提交什么。一次研究持续 1.6–7.9 小时,共开 24 次模型会话,产生数百到上千次工具调用。
流程里哪些由代码决定、哪些由模型决定,需要说清楚。阶段顺序、7 轮循环、工程检查(编译、试运行、覆盖率)、训练期回测和评分链由代码强制;计划结构、研究方法论和选择准则(理由的逻辑占 80%、训练期绩效占 20%,入选因子两两相关不超过 0.55)由提示词引导;怎么理解研报、提什么假设、每轮提多少、在哪个已有因子上改、怎么实现、最后提交什么,由模型自主决定。本文评的是最后这一部分。
评测集的 7 篇研报发表时间都早于测试期。我们按以往自动研究在训练期的表现,把它们分成四个难度层:“基线已强”指照研报原式实现就已经很好,“研究可提升”指原式较弱、迭代后明显变好,“天花板高”指强基线上还能继续提升,“困难”指迭代后仍然较弱。
| 编号 | 研报主题 | 难度层 | 公式完整度 |
|---|---|---|---|
| A1 | 识别个股动量效应,合成“球队硬币”因子 | 研究可提升 | 缺参数 |
| A2 | 用股价跳跃识别信息冲击 | 研究可提升 | 完整 |
| B1 | 成交量激增时刻的价格行为 | 基线已强 | 完整 |
| B2 | 股价与资金流之间的相互关系 | 基线已强 | 缺参数 |
| C1 | 用分钟单笔成交金额刻画大资金行为 | 天花板高 | 完整 |
| C2 | 价量自相关的错位版本 | 天花板高 | 完整 |
| D1 | 寻找相似的 K 线形态 | 困难 | 缺参数 |
03 / 评分:在模型没见过的行情上回放
提交冻结后,独立评分器重新编译源码,在 2024–2025 年共 485 个交易日的行情上回放。这段行情晚于全部研报的发表时间,模型在研究中也看不到它的回测结果。
打分只看一个数。先剔除市场、行业和风格能够解释的收益,只留下代表选股能力的部分;再按因子值把股票分成十层,计算高值五层相对十层平均的收益差,取它的年化夏普比率 S。S < 2 记 0 分,否则记 min(S/6, 1),乘 100 为百分制;选择不提交也记 0 分。
这几处设计各自堵住一种捷径。夏普比率与仓位大小无关,不会被少数几天的极端行情主导;剔除风格,是为了不让“换了包装的已知风险暴露”拿分,比如单纯偏好小市值股票;设门槛,是为了过滤碰巧有效的因子——在 485 个交易日上,S = 2 大约对应 t ≈ 2.79,纯靠运气很难达到。整个评分是确定性的回测,不依赖 LLM 裁判,所有模型用同一把尺子。
只看最终分数,回答不了“差在哪里”。我们因此把一次研究按流程拆成三层,每层都用同一个 S 衡量:
- 复现:第 0 轮按研报原式实现的候选中,训练期 S 的最高值,看模型照着研报能做到多好;
- 生成:全部候选训练期 S 的 90% 分位,看模型自己能想出多好的候选(不取最大值,因为最大值会随候选数增加而变大);
- 选择:最终提交的因子在测试期的 S,同时报告它在训练期的 S,便于和前两层对比。
分数还得是干净的。研究与评分之间的隔离措施分两类:“机制”指一旦违反运行就会失败,“约定”指靠提示词和流程约束,再由事后检查确认。
| 措施 | 类型 | 检查结果 |
|---|---|---|
| 研究容器只读,行情和研报只读挂载 | 机制 | 启动时检查挂载状态 |
| 评分器断网,只接收提交目录并重新编译源码 | 机制 | 实测评分容器只读、无网络 |
| 参考答案与评分测试不进入研究环境 | 机制 | 由打包代码保证 |
| 不读取测试期行情,不联网 | 约定 | 检索 28 次运行执行过的全部命令:未发现 |
| 评分配置不用于调参 | 约定 | 1 次读取评分配置,内容与提示词中公开的信息一致 |
| 因子不得前视 | 约定 | 逐处复核 27 个提交的源码:未发现 |
有一个例子值得单独说。在 C1 这道题上,muse-spark-1.3 在最终选择阶段自查时发现,全部 210 个候选都在开盘时读取了当天的收盘价,也就是前视。它逐个补选、逐个审计,最后选择不提交。我们复核了这 210 个源文件,结论一致。这是一次正确的拦截;真正的问题出在上游的编码阶段:只应作用于前一交易日数据的过滤条件被用到了当天的数据上,此后的字段映射和工程检查都没有发现。
04 / 结果:两档表现,集中在两道题
| 模型 | 平均分(95% 区间) | 过线题数 | 研究耗时 | 每题 token(百万) |
|---|---|---|---|---|
| gpt-6.1-sol | 50.5(35.5–65.5) | 5 / 7 | 6.9 小时 | 69 |
| gpt-6.1-terra | 45.8(31.2–63.5) | 5 / 7 | 2.0 小时 | 31 |
| deepseek-v4.1-flash | 24.0(12.8–49.3) | 3 / 7 | 4.8 小时 | 199 |
| muse-spark-1.3 | 23.1(18.4–38.2) | 2 / 7 | 4.8 小时 | 102 |
平均分为 7 题得分的平均,区间来自对测试期交易日的重抽样,反映行情涨跌带来的随机性;过线指测试期 S ≥ 2;研究耗时为 7 题的中位数;token 含缓存命中的输入和输出。推理强度上,deepseek-v4.1-flash 为 max,其余三个为 xhigh;两个 GPT 模型原生接入 Codex CLI,另外两个经兼容配置接入,结论限定为这套工具链下的表现。
本次运行中,四个模型分成两档:gpt-6.1-sol 50.5 分、gpt-6.1-terra 45.8 分,明显高于 deepseek-v4.1-flash 的 24.0 分和 muse-spark-1.3 的 23.1 分。对测试期交易日重新抽样,两个 GPT 模型与另外两个模型之间的差距显著(p 在 0.001–0.008 之间),两档内部的差距不显著。
但这个两档划分依赖少数几道题。逐题比较时,没有一对模型的差距达到 0.05 的显著水平;去掉 C1 和 D1 两道题,四个模型的平均分依次变为 38.6、39.2、33.6、32.4,最大差距从约 27 分缩小到约 7 分(图 2)。
题目本身决定了大部分结果(图 3)。B1(成交量激增)和 C2(价量自相关错位)上四个模型全部过线,A2(股价跳跃)和 B2(股价与资金流)上全部没过。真正起区分作用的只有 A1、C1、D1 三道题,其中 D1 最极端:两个 GPT 模型的测试期 S 为 5.76 和 4.75,另外两个模型是 −0.09 和 0.06。
模型确实在研报之外做了研究。28 次运行中有 1 次选择不提交,其余 27 个提交共包含 44 个因子,其中只有 4 个直接来自第 0 轮的研报复现,其余都是后续轮次改造的结果。
交互多也不等于研究好。gpt-6.1-terra 只用了约三分之一的时间和三分之一的输出 token,就拿到与 gpt-6.1-sol 接近的分数;deepseek-v4.1-flash 的工具调用是 gpt-6.1-sol 的 3 倍以上,得分却不到一半。
还要说明一点:评分只看剔除风格后的选股能力,不计交易成本。为了对“值多少钱”有个直观印象,我们把每个模型 7 个提交的纯多头组合等权合成。扣费前,四个模型相对可交易股票池都有正的超额收益(年化约 4%–9%);但日均单边换手在 15% 左右,按单边 0.1% 扣费后,只有 gpt-6.1-terra 仍为正(年化 1.64%)。这是回溯模拟,不是实盘;要把这类研究用于实际投资,还得控制换手和成本。
05 / 差距出在哪一步:训练期看不出,测试期才拉开
把三层放在一起看,结论很清楚:在训练期,四个模型几乎没有区别(图 4)。复现层 2.6–3.2,生成层 3.7–3.8,提交因子的训练期 S 为 3.5–3.8,四个模型彼此交叠。到了测试期,选择层才分开:两个 GPT 模型为 3.34 和 3.11,另外两个为 2.12 和 2.25。
按能力逐项看,差距的位置更具体。
| 模型 | 未过检查 | 同轮相关 | 提交的排名分位 | 训练–测试差 | 过拟合次数 |
|---|---|---|---|---|---|
| gpt-6.1-sol | 0.2% | 0.31 | 0.83 | 0.13 | 1 |
| gpt-6.1-terra | 0.0% | 0.37 | 0.78 | 0.38 | 1 |
| deepseek-v4.1-flash | 0.6% | 0.62 | 0.92 | 1.69 | 3 |
| muse-spark-1.3 | 6.4% | 0.54 | 0.89 | 1.27 | 4 |
未过检查是没通过工程检查的假设比例;同轮相关是同一轮候选之间日收益的平均相关,越低说明想法越不一样;排名分位是提交的因子在本次全部候选中的训练期排名,1 表示最好;训练–测试差是提交因子的训练期 S 减测试期 S;过拟合指训练–测试差 ≥ 1.5 且测试期 S < 2。
文档理解不是差距的来源。 28 次运行的研究计划都覆盖了研报的全部核心方法(每篇 4–6 项)。复现层甚至是 muse-spark-1.3 最高,标注中也没有发现漏读或误读研报的例子。
实现可靠性只在一个模型上成为问题。 muse-spark-1.3 有 6.4% 的假设没通过工程检查,工程检查累计失败 14 次;其余三个模型的未通过率都不超过 0.6%。
想法的多样性差别明显。 两个 GPT 模型的同轮相关为 0.31 和 0.37,另外两个为 0.62 和 0.54。值得注意的是,“改进后的因子比原因子更好”的比例反而是 muse-spark-1.3 最高(0.47):小幅修改,更容易在训练期变好。
判断与选择的差别最大。 两个 GPT 模型的训练–测试差只有 0.13 和 0.38,另外两个是 1.69 和 1.27。deepseek-v4.1-flash 的提交在自己全部候选中训练期排名最靠前,测试期却最差。在 27 个提交上,排名分位与训练–测试差的秩相关为 0.45:挑得越接近训练期最优,到测试期跌得越多。
06 / 一道题,两种研究方式
D1 来自一篇 2020 年的研报,思路是寻找历史上与当前相似的 K 线形态。研报缺少关键参数,属于“困难”层。gpt-6.1-sol 和 deepseek-v4.1-flash 在这道题上分差最大:测试期 S 分别为 5.76 和 −0.09。同一篇研报、同一套数据、同样的反馈,两个模型走出了完全不同的路。
读研报时,两者都发现研报缺少关键参数,也都在计划里写明了自己的补缺方式。分歧从这里开始:gpt-6.1-sol 把研报当成一串待检验的必要条件,拆成 7 个组件、8 个研究方向;deepseek-v4.1-flash 把它当成一个只需调参的模型,主要在窗口长度、预测期限和相似度函数上做网格搜索。
第 0 轮,gpt-6.1-sol 提出 26 个假设,除了原式基线,同一轮就登记了“只删去一个原文组件”的对照实验;deepseek-v4.1-flash 提出 36 个,对照以参数网格为主。两者第 0 轮的反馈都显示:研报的方向在训练期不成立。
接下来的迭代决定了结果。gpt-6.1-sol 用对照否定了原始的形态解释:删去某些组件后结果不变,说明它们不是必要条件。它在反思中写道“分档并未解决高端,未证明联合原式必要”,随即停止相关微调,转向第 0 轮另提的一个基于日内数据的方向;此后的每一次转向,都由“只改一个组件”的对照触发。deepseek-v4.1-flash 则保留训练期最强的分支,把与收益明显负相关的分支反向使用;对照显示增量有限之后,研究对象没有变,后续的变化集中在参数、权重和组合方式上。
轨迹的形状也因此不同(图 5)。gpt-6.1-sol 每轮的假设数保持在 18–26 个,对照实验的占比从第 0 轮的 5/26 升到第 6 轮的 14/21;deepseek-v4.1-flash 从 36 个降到 6 个,最后两轮以已有分支的组合为主。
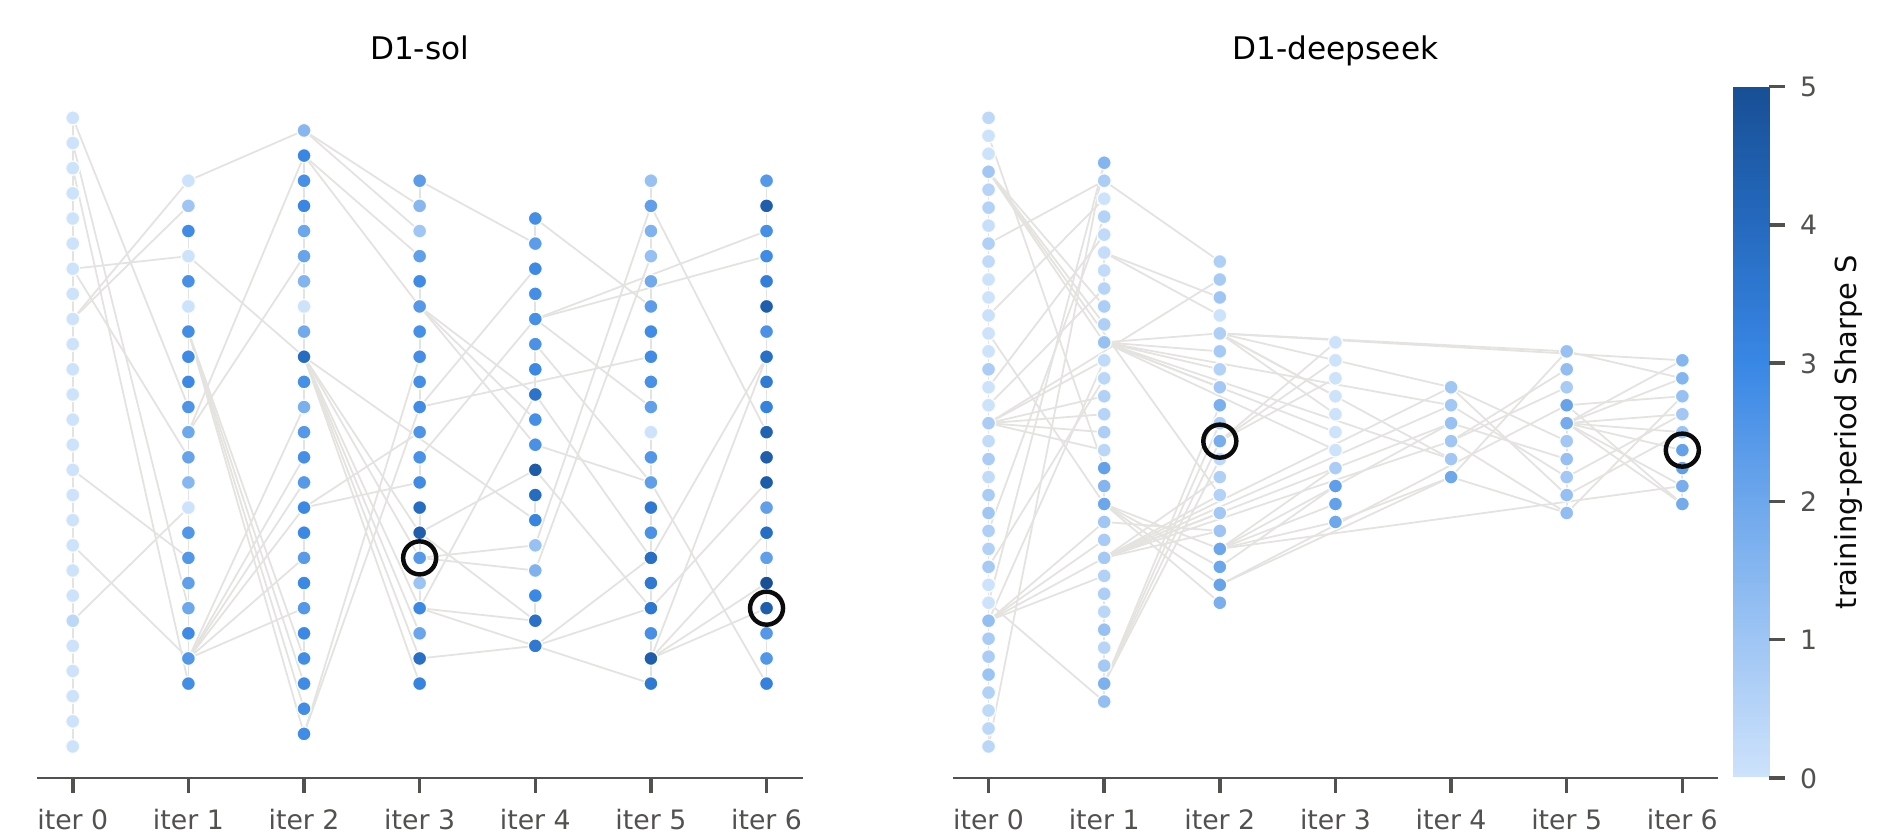
选择阶段的差别最直接。gpt-6.1-sol 提交了两个低相关的因子,理由中主动写明“多轮样本内筛选存在赢家偏差”,并解释为什么不选同簇中训练期成绩更高的变体;所选因子在自己全部候选中的训练期排名只在 0.70 分位。deepseek-v4.1-flash 的理由停留在训练期分层读数和季度胜率的比较上,所选因子在 0.93 分位。
结果是:gpt-6.1-sol 提交因子的训练期 S 为 3.44,测试期升到 5.76;deepseek-v4.1-flash 训练期 1.98,测试期 −0.09。
07 / 差距可能来自哪里
一个案例不足以下结论。把 28 次运行放在一起看,差距可能有三个来源。它们发生在同一套流程、同样的反馈之下,更可能反映模型本身的研究习惯;但每个组合只跑了一次,这里只说“可能”。
第一,想法在迭代中收窄。 deepseek-v4.1-flash 第 6 轮平均只剩 6.0 个假设,gpt-6.1-sol 仍保持在 15 个左右。越集中于局部微调,训练期越容易变好,同轮候选却越来越相似。C1 上也是如此:gpt-6.1-sol 在第 0 轮之后每轮仍有 21–29 个低相关的假设,并配有成体系的对照;deepseek-v4.1-flash 从第 2 轮起每轮只剩 2–4 个,几乎全是三个因子合成权重的微调。对照实验的用处也不只是排除错误。在 B1 上,gpt-6.1-sol 用逐步删除条件的对照证明,研报强调的“成交量激增”条件可以去掉,最终提交了更简单的版本,测试期 S = 4.69。
第二,靠训练期成绩挑因子,本身就不可靠。 在 27 个提交上,训练期 S 与测试期 S 的秩相关为 0.63,看起来训练期成绩有参考价值;但这主要来自题目之间的难度差别。按题目去掉均值之后,秩相关只剩 0.14:同一道题内,训练期成绩几乎预测不了测试期。B2 是四个模型共同的失误:训练期都不差,测试期全部 S < 2。gpt-6.1-terra 注意到了训练期最后一个季度收益转负,但仍然提交;muse-spark-1.3 把弱季度解释为“互补”,而不是风险。
第三,交几个因子。 两个 GPT 模型平均每次提交约 2 个因子,另外两个模型多数只交 1 个。多个低相关因子合成之后,测试期明显更稳:
| 提交因子数 | 运行数 | 测试期过线 | 平均训练–测试差 | 平均测试期 S |
|---|---|---|---|---|
| 1 个 | 13 | 4 | 1.55 | 2.03 |
| 2 个 | 11 | 8 | 0.23 | 3.23 |
| 3 个 | 3 | 3 | 0.10 | 3.85 |
所以“GPT 模型选择更克制”,相当一部分可以由“多交了低相关的因子”解释。需要注意,训练–测试差的两边口径不完全一致:训练期按提交的因子单独计算,测试期按合成后的信号计算。即便如此,作为一条研究策略,这个结论本身就有用:与其押注训练期最好的那一个,不如交一组彼此不同的因子。
08 / 这次评测说明了什么,还没说明什么
这次评测的结论有明确的边界。评测集只有 7 道题,每个模型在每道题上只运行了一次,单次运行的随机性没有估计,两档划分主要由 C1、D1 两题拉开。“不使用当日开盘后数据”目前只通过日志检索和源码复核确认,还没有做逐日扰动测试,即把当天开盘后的数据换成随机值,检查因子值是否改变。过程指标中的标注项由 1 名 LLM 标注者按书面规则判定,人工复核还在进行。
还有两处可能的偏差。两个 GPT 模型原生接入 Codex CLI,另外两个经兼容配置接入,实现层面的部分差距可能来自接入方式。模型也可能在预训练中见过这些研报的原文和 2024–2025 年的因子跟踪报告,因而“知道”哪类因子在测试期有效。此外,结论限定于这套研究流程和 A 股量价、订单流类研报,不能直接外推到完全自主的研究或其他类型的研究。
下一步有三件事:加一个晚于所有模型训练截止日期的测试窗口,比如 2026 年上半年;补上“研报原式直接提交”和随机因子两个参照,让 S ≥ 2 有多难有个直观的对照;每个组合多跑几次,估计随机性,并扩大评测集。
如果用一句话总结这次评测:研究型智能体之间的差距,不在读懂研报、写出代码,而在判断哪些结果经得起新行情的检验。评测这类智能体,不能只看它在已知数据上做得多好;把研究拆成复现、生成、选择三层,在冻结的未来数据上打分,才能把这种判断能力单独量出来。