智能体自己做因子研究:一份研报如何长出一棵因子树
从一份券商研报出发,智能体用 7 轮、232 个候选,把研报里失效的思路改成了有效因子。本文用这次运行的真实记录,讲每一轮在做什么、为什么这样改。
研究员做因子,大部分时间花在一个循环里:提出想法,写成代码,看回测,再根据结果改想法。循环本身不复杂,难的是每一步都做对:数据不能偷看未来,每次改动要说得清改了什么,结果变好或变坏要找得到原因。
我们让智能体自己跑这个循环。人只设定规则:阶段顺序、可用的数据和工具、回测口径和不能越过的底线。读研报、提假设、写代码、解读结果、决定下一步改什么,都由智能体完成。
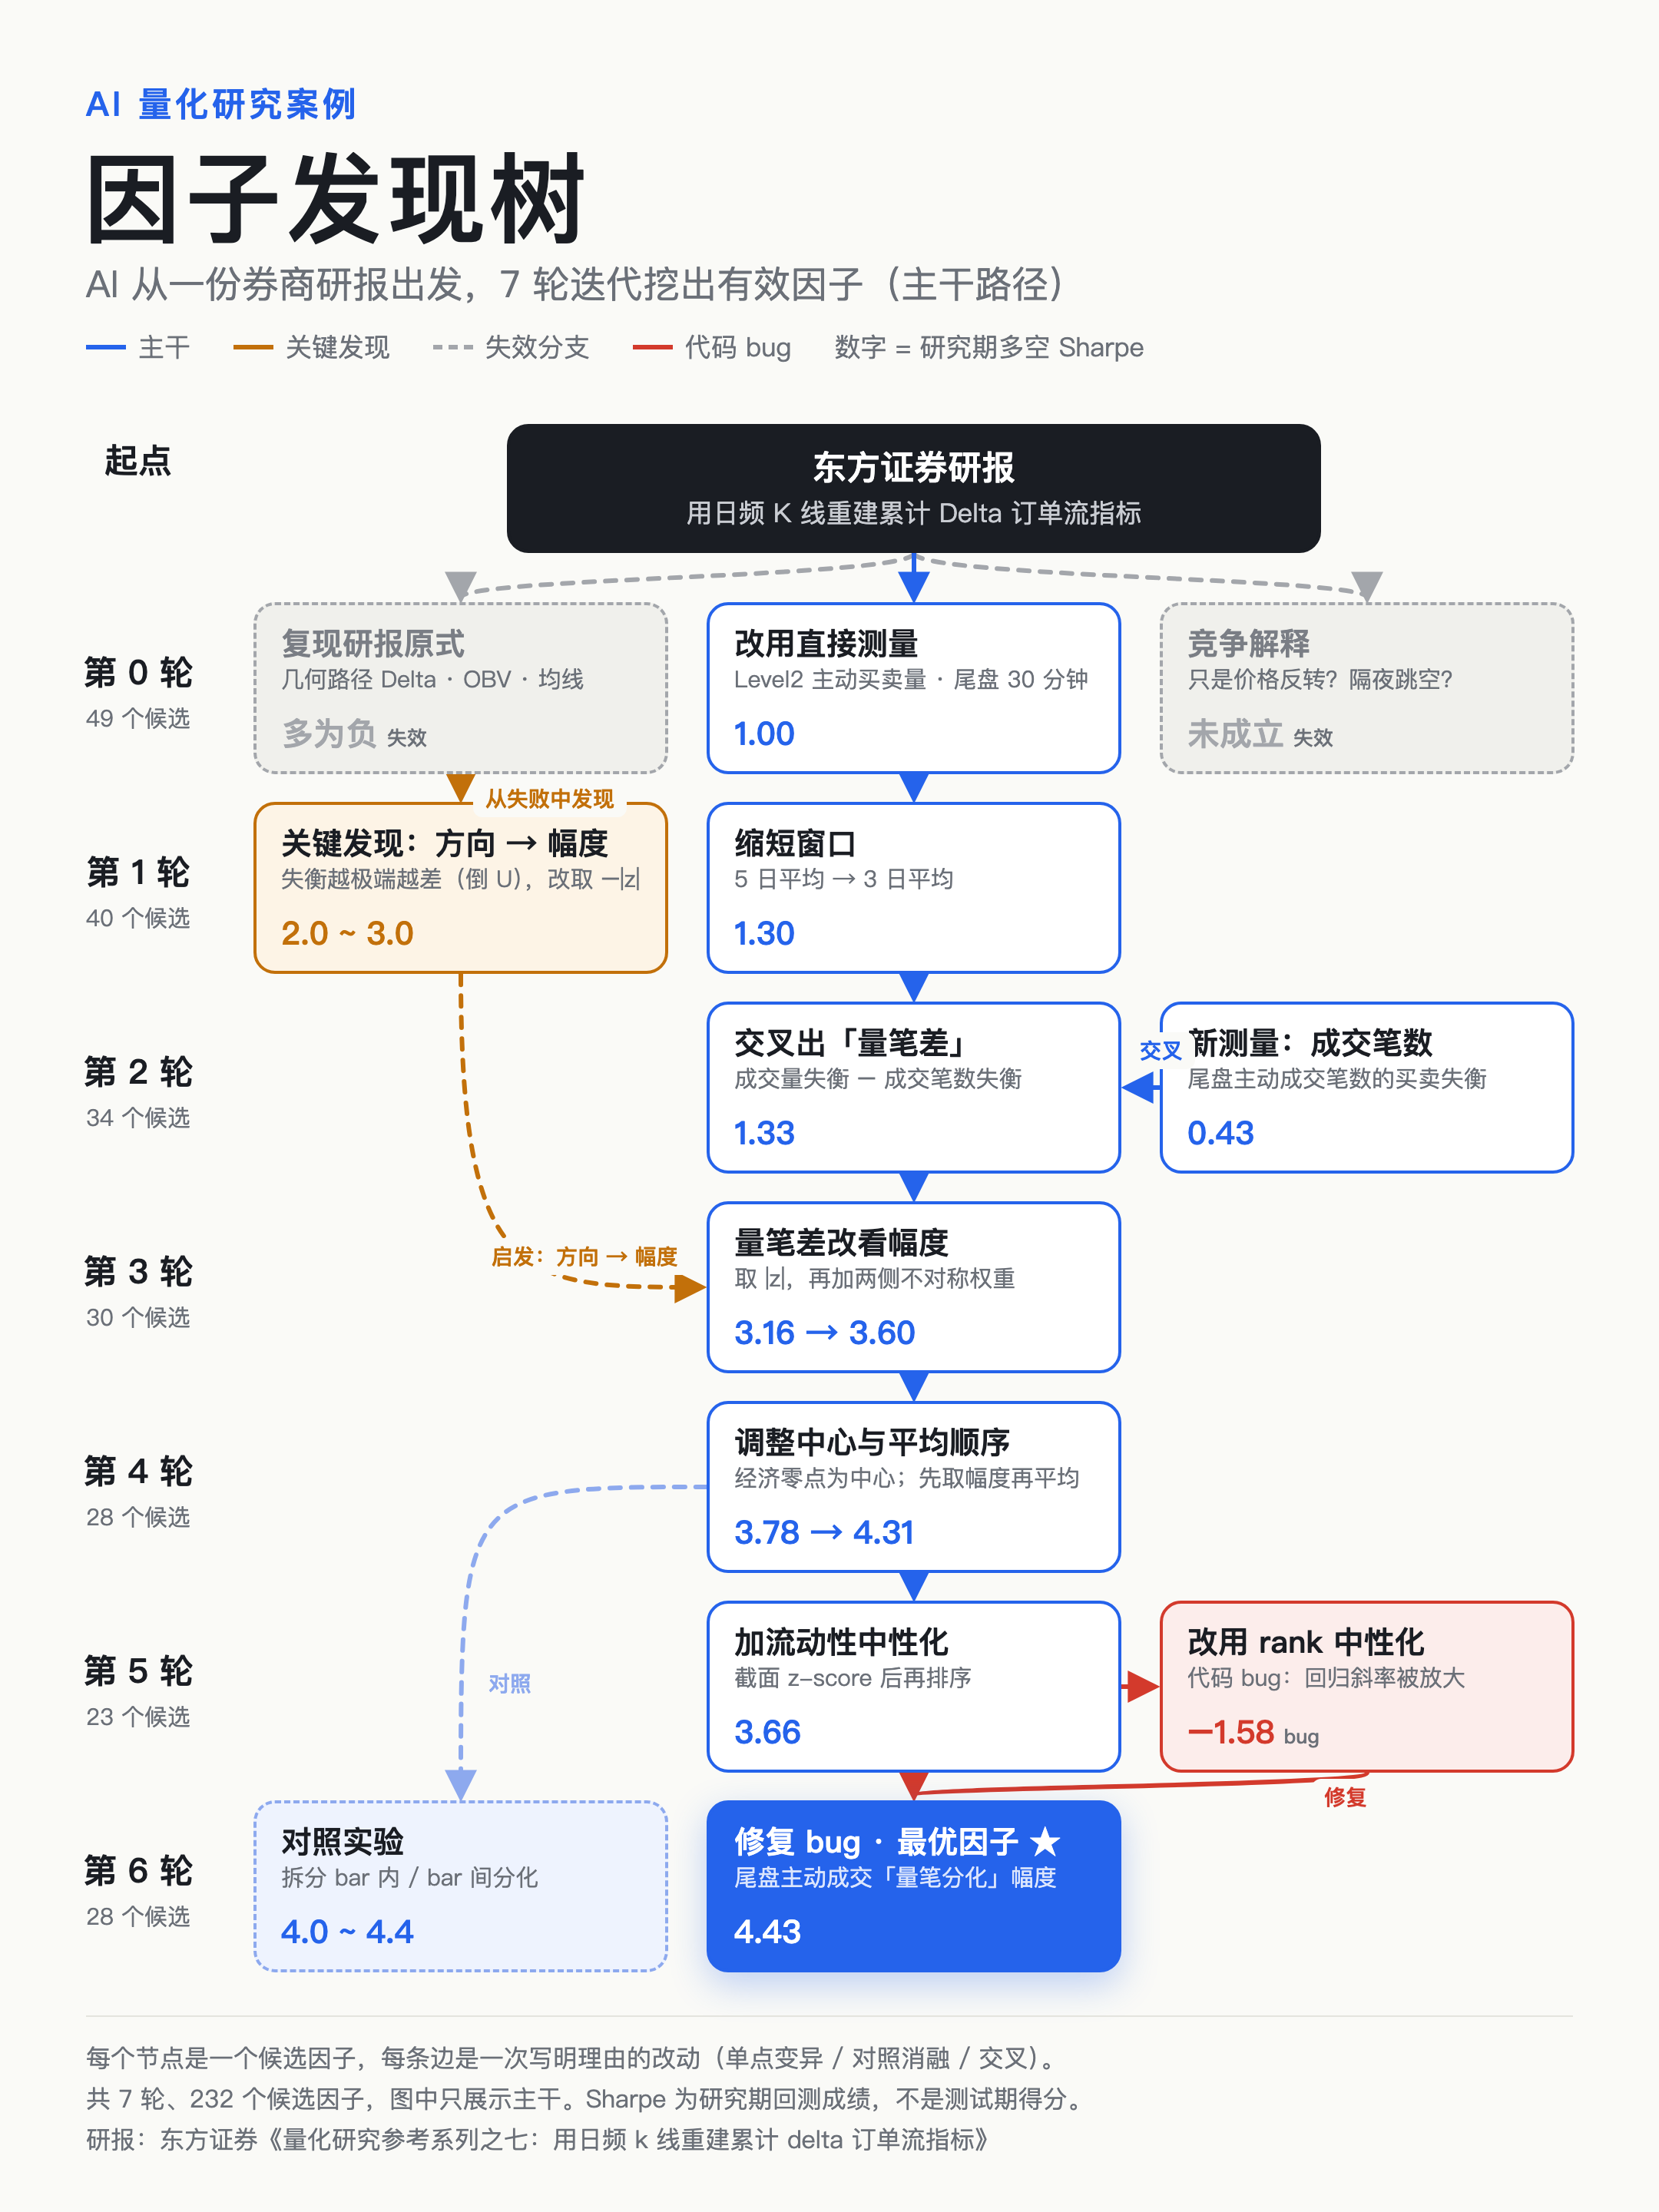
本文用一次完整运行做例子。起点是东方证券的研报《用日频 K 线重建累计 Delta 订单流指标》。研报原式在我们的回测里是负收益;智能体跑了 7 轮、提出 232 个候选因子,最好的一个研究期多空夏普达到 4.43。下面逐轮看它是怎么走到这里的。
01 / 一轮迭代怎么跑
所谓因子,是每天给每只股票打的一个分数,用来预测它未来几天的相对收益。这个任务的目标是借鉴研报思路,提高对未来 3–5 天收益的预测能力。
研究开始前先做一次计划。几个不同的模型各自读研报、写初稿,再汇总成一份研究计划:研报原式怎么实现;哪些是原文结论,哪些是待检验的假设,各出自原文哪一节;数据有什么限制。比如论文的方法是为没有逐笔数据的场景设计的,而我们的数据里有分钟级的主动买卖统计,计划里要写明哪里照原文做、哪里换了口径。
之后每一轮都走同样的六步(图 1):
| 步骤 | 做什么 | 由谁完成 |
|---|---|---|
| 提假设 | 提出本轮候选,每个写明父因子、改了哪一处、为什么改 | 智能体 |
| 对字段 | 把公式里的每个变量对到具体数据字段,确认打分时这份数据已经可见 | 智能体 |
| 写代码 | 按固定格式用 C++ 写打分规则 | 智能体 |
| 检查 | 编译,试跑几个月,空值太多或输出全是常数就退回修复 | 固定工具 |
| 回测 | 按分数把股票分成十层,算每层收益、多空夏普、换手,以及和市值等风格的相关性 | 固定工具 |
| 反思 | 读全部回测结果,判断哪些假设成立、哪些失败、原因是什么,写成下一轮的起点 | 智能体 |
每个候选都带一份记录:编号、父因子、改动说明。比如第 4 轮的一条:父因子是本轮第 7 号;改动是把"3 日均值的绝对值"换成"每日绝对值的 3 日均值",其余不变;目的是检验跨日的正负抵消有没有丢掉信息。
改动分四类:
- 单点变异:只改一处,看这一处的作用。共 93 个。
- 交叉:把两个父因子各自有效的部分组合起来。共 25 个。
- 对照:把某一部分拿掉,或换成不含信息的替身,检验它是不是必需。共 101 个。
- 新起点:不继承任何父因子,检验一个竞争性解释或一种新测量。共 11 个。
另有 2 个是修复代码错误。232 个候选里,对照实验占了将近一半。"批量生成、按分数筛选"的做法里没有这一类,后文会看到它起了什么作用。
02 / 案例:从一份研报长出一棵树
先说研报的思路。日 K 线只有开高低收和成交量,看不到当天的成交顺序。论文用开盘价相对当天价格区间中点的位置,推断价格是先到最高点还是先到最低点;再按每段价格移动的幅度,把当天成交量分配到各段,估计出"主动买入减主动卖出"(Delta),最后取 50 日均线。论文的证据是两只美股的案例:在拐点前,Delta 比 OBV 更早转向。
第 0 轮:复现失败,也排除了几个竞争解释。 智能体先按原文实现基线:原式 Delta、50 日均线版、OBV 对照,研究期多空夏普分别是 −1.02、−1.74、−0.89,全部为负。同一轮它还检验了几个竞争解释:就算这个信号有效,会不会只是价格反转、收盘位置或隔夜跳空在起作用?这三个解释单独做成因子,夏普在 −1.88 到 0.05 之间,也不成立。
另一个方向是换测量方式。研报用 K 线"猜"主动买卖,是因为没有逐笔数据;我们有按分钟统计的主动买入量和主动卖出量,可以直接测。直接测全天的买卖失衡,夏普 0.63;只看尾盘 30 分钟,升到 1.00;只看开盘 30 分钟,0.54。"尾盘直接测量"成了后面的主干。第 0 轮 49 个候选,只有 12 个夏普为正。
第 1 轮:从失败里读出倒 U 形。 反思时,智能体没有只看多空夏普这一个数,而是逐个读了失败因子的十层收益。研报思路的几个版本形状一致:中间几层稳定赚钱,两端都亏(图 2 左)。也就是说,"买方越强越好"不成立;失衡越极端,之后的表现反而越差。
它据此换了预测对象:不看失衡的方向,看失衡偏离常态的幅度,幅度越大打分越低。三个不同的父因子做同样的改动,夏普分别从 −0.70、−1.02、−1.74 变成 2.47、2.04、1.88(图 2 右)。同一个改动在三个父因子上都成立,说明它不是对某个公式的偶然拟合。
这一轮主干上的改动比较平淡:尾盘失衡的均值窗口从 5 天缩到 3 天,夏普 1.00 → 1.30。
第 2 轮:新测量和交叉。 智能体加了一个新测量:尾盘主动成交的笔数失衡,单独看夏普只有 0.43。再把它和主干交叉,做成"量笔差",即成交量失衡减去成交笔数失衡,用来区分同样是买多卖少,是少数大单在买,还是大量小单在买。结果夏普 1.33,只比父因子高 0.03。对照实验给出同样的结论:拿掉笔数这一项,夏普 1.30,几乎不变。
第 3 轮:两条线汇合。 智能体把第 1 轮"看幅度"的认识用到量笔差上,夏普升到 3.16;再给偏离的正负两侧不同权重,升到 3.60。这时再做同样的对照,拿掉笔数这一项,夏普掉到 1.42。第 2 轮看起来没用的交叉,换成幅度形式之后成了主要的收益来源。没有对照实验,这一步只能看出总分涨了,看不出是哪一部分在起作用。
第 4 轮:调整中心和平均顺序。 改了两处细节。一是幅度的参照点从"当天全市场平均"改成"买卖相等"这个经济意义上的零点,夏普 3.78。二是先算每天的幅度、再取 3 日均值,而不是先平均、再取幅度。后一种算法会让"昨天大买、今天大卖"互相抵消,改了之后夏普 4.31。
第 5 轮:一个代码错误。 智能体在主干上加流动性中性化,也就是剔除因子里和流动性相关的部分。用标准化方式做,夏普 3.66,比不加还低;换成排序方式做,夏普变成 −1.58,十层形状整个翻了过来。
第 6 轮:先查实现,再下结论。 这个结果有两种可能:排序方式的中性化确实有害,或者代码写错了。智能体注意到,−1.58 那个因子和风格因子的相关性也异常地高,于是回去读源码,发现回归斜率的分子是求和,分母却多除了一次样本数,斜率被放大了与当天股票数相同的倍数,中性化反而把因子扭曲了。它把这一条标为实现错误,写明 −1.58 不能当作研究证据,只改这一处、其余不动重跑:夏普 4.43,是 7 轮里的最高值。
同一轮在相邻分支上还做了一组对照:把每天的幅度拆成 5 分钟 K 线内部和相邻 K 线之间两部分,分别保留或拿掉。四个变体都在 4.0–4.4 之间,说明主干的提升不依赖某个拆分细节。
03 / 循环能自我修正,靠三个设计
回头看这棵树,关键几步都不是"想到一个好公式",而是流程让错误能被看见、被归因。
反馈要完整。 回测交回的不是一个分数,而是十层收益、分季度夏普、换手和风格相关性。倒 U 形只有看分层才看得出来。如果只给多空夏普,研报原式就是一个 −1.02 的失败,会被直接丢掉。
改动要能归因。 每个候选尽量只改一处,再配对照实验。第 2、3 轮的量笔差说明了原因:同一个组合,换一种形式,价值完全不同,只有对照能分清。
异常先查实现。 结果突然翻转时,先怀疑代码,再怀疑假设。第 5 轮的 −1.58 如果被当成研究结论,"排序方式中性化"这个方向就会被错误地放弃。
此外,所有记录都保留。失败的候选、失败的原因、修复的过程都留在历史里;每一轮的反思从完整历史出发,而不是只看上一轮的最好结果。
04 / 和 CogAlpha 的异同
近期也有工作沿类似思路挖因子。CogAlpha(Liu 等,arXiv:2511.18850)让大模型以代码形式生成因子,经多智能体质量检查后计算 IC 等五个预测指标,按分位数阈值选出合格因子,再用"变异"和"交叉"两种操作进化出下一代。
两者的共同点:因子都用代码表示,并附有解释逻辑的说明;都有代码检查和修复环节;都用变异和交叉产生新候选,并把历史上的好坏样本反馈给模型。
不同之处主要在三点:
| CogAlpha | 本流程 | |
|---|---|---|
| 起点 | 21 个按研究方向分工的智能体,从开高低收和成交量出发 | 一份研报:先复现原式,原文结论和新假设分开记录 |
| 反馈与选择 | 五个预测指标,按分位数阈值自动筛选 | 十层收益、分季度夏普、换手、风格暴露,由智能体逐条解读 |
| 改动方式 | 变异、交叉 | 变异、交叉,加上对照实验和新起点;每个候选记录父因子和改动理由 |
CogAlpha 的长处是规模和自动化,适合在大空间里广泛搜索。本流程更接近研究员的工作方式,每一步都要求可归因,代价是每轮候选较少(23–49 个)。两种做法并不互斥。
05 / 局限与下一步
- 图中的夏普都是研究期成绩。 研究期为 2022–2024 年。232 个候选在同一段数据上反复挑选,最好的那个必然带有选择偏差。智能体在反思里也写明:这些判断都是样本内的认识,不是样本外的确认。
- 还缺独立的样本外打分。 最终成绩应由独立评分器在研究期之外的行情上打分,像量化研究评测那样,而不是由智能体自己判断。本案例还没有做这一步。
- 最终选择还在开发。 设计是:结合迭代树和因子值之间的相关性,选出几个互补的因子,统一方向和尺度后等权合成;验收标准是合成因子在独立区间上达到已有最好实验成绩的约 80%。选因子只能用研究期数据,不能根据评测区间的反馈调整。
- 研究过程完整保存。 每个候选的源码、回测结果、父子关系,以及各阶段模型会话的原始记录都留存下来,沉淀为研究轨迹数据。